가정해 보겠습니다. 공장의 베어링 진동이 평소보다 커졌습니다. 현장팀은 점검 주기를 30일에서 14일로 줄이자고 제안합니다. 관련 문서와 고장 기록은 찾았습니다. 그런데 버튼을 누르려는 순간, 더 어려운 질문들이 남습니다. 이 판단은 어떤 기록에서 나왔을까요? 누가 변경을 승인할 수 있을까요? 주기를 바꾼 뒤 고장률과 비가동 시간이 실제로 줄었는지는 누가 확인할까요?
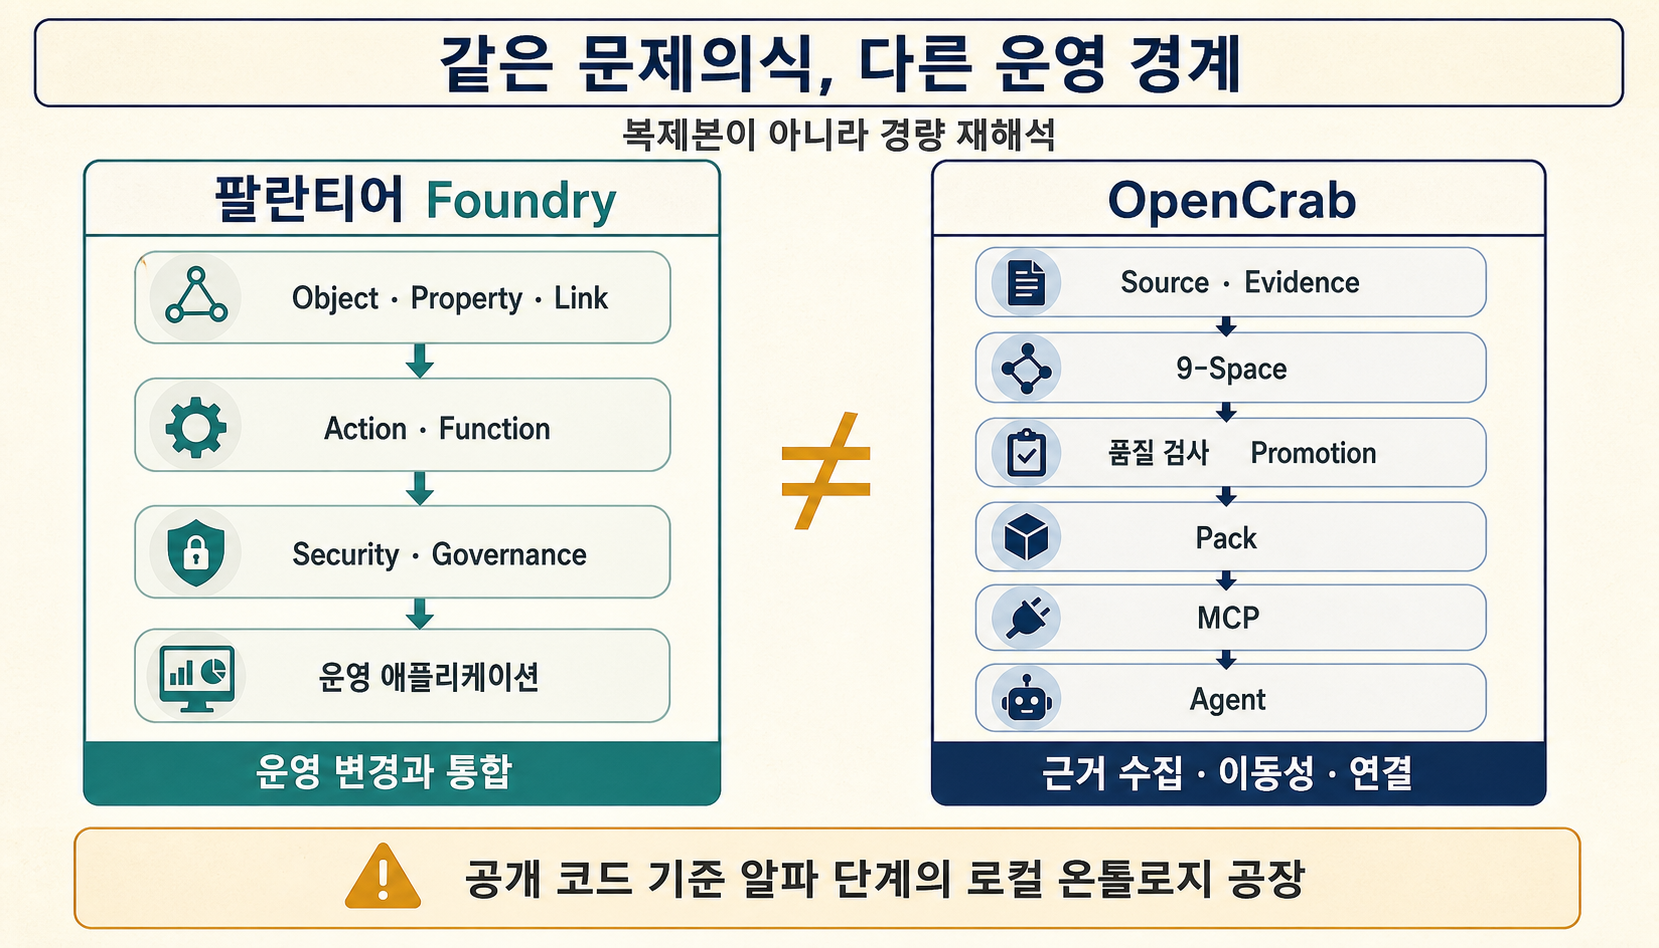
Palantir Foundry와 OpenCrab은 둘 다 이런 문제를 온톨로지로 풀려고 합니다. 그렇다면 OpenCrab은 Foundry의 축소 복제본일까요? 겉으로는 그렇게 보일 수 있습니다. 그러나 제작 배경과 공개 코드를 따라가면 첫 답은 곧 깨집니다. 두 시스템은 같은 문제의식에서 출발했지만, 근거를 모으는 일부터 실제 변경을 책임지는 지점까지 서로 다른 길을 택했습니다.
먼저 결론
OpenCrab은 Palantir Foundry의 축소판이 아니라, 운영 온톨로지의 일부 책임을 작은 부품으로 다시 나눈 프로젝트입니다. Foundry가 업무 객체·행동·권한을 한 플랫폼에서 연결한다면, OpenCrab은 문서와 로그를 Evidence·Claim·Outcome·Lever·Policy로 읽고 검증한 지식을 Pack과 MCP로 Agent에 전달합니다. 둘의 차이는 기능 수보다 근거에서 실제 변경까지 어디를 누가 책임지는가에 있습니다.
첫 단서: OpenCrab은 AIP를 쓰던 경험에서 시작됐습니다
OpenCrab 제작자의 출발점은 Palantir AIP였습니다. AIP(Artificial Intelligence Platform)는 Palantir 공식 문서에서 AI를 조직의 데이터와 운영에 연결하는 플랫폼으로 설명되며, AIP Logic·Chatbot Studio·Evals 같은 도구가 Ontology 위에서 LLM 워크플로·Agent·함수를 만들도록 돕습니다. (Palantir AIP overview) 공개 Threads 글에서 제작자는 2025년 여름 AIP를 업무에 쓰면서 온톨로지를 업무에 도입하는 방식이 강력하다고 느꼈지만, 실제로 다루는 과정은 쉽지 않았다고 적었습니다. 그때부터 혼자 쓸 온톨로지 도구를 만들기 시작했고, 초기의 Langent를 거쳐 OpenCrab으로 발전시켰다고 설명합니다. (OpenCrab 제작자의 개발 배경)
이 배경을 알고 나면 OpenCrab을 보는 질문도 달라집니다. “Foundry를 얼마나 작게 복제했나?”보다 **AIP를 쓰며 경험한 운영 온톨로지의 장점을 개인과 작은 팀이 다룰 수 있는 부품으로 어떻게 다시 풀었나?**를 물어야 합니다.
출발점이 같다고 목적지까지 같은 것은 아닙니다. 그 차이를 보려면 먼저 Foundry, Ontology와 AIP가 각각 무슨 일을 맡는지 나눠야 합니다.
Foundry·Ontology·AIP를 나누면 차이가 보입니다
같은 것은 아닙니다. 아주 거칠게 나누면 Foundry는 기업의 데이터와 업무를 운영하는 플랫폼이고, Ontology는 그 안에서 현실의 업무 객체와 관계·행동을 공통 의미로 묶는 계층입니다. AIP는 모델과 Agent가 그 Ontology와 데이터를 활용해 분석·함수·자동화와 업무 흐름을 만들도록 하는 AI 개발·실행 표면입니다. (Palantir Ontology overview, AIP overview)
Palantir Foundry
데이터 · 업무 플랫폼
        ↓
Foundry Ontology
Object · Property · Link · Action · Function · Security
        ↓
Palantir AIP
LLM · Agent가 Ontology를 읽고 분석·함수·자동화에 활용
여기서 한 가지 경계가 중요합니다. AIP가 Ontology edit와 Action, 평가와 관측 도구를 연결할 수 있다는 사실이 모든 AI 작업을 자동 승인·검증하는 닫힌 운영 루프를 뜻하지는 않습니다. 2026년 8월 29일 현재 AIP Logic의 staged writes는 Beta이고, Automate는 설정에 따라 Action을 자동 적용하거나 사람 검토용 proposal로 보낼 수 있습니다. AIP Evals도 정의한 test case와 evaluator 안에서 함수를 평가하는 도구이지 실제 운영 전체의 안전성을 자동으로 보증하는 장치는 아닙니다. (Staged writes, AIP Logic integration with Automate, AIP Evals)
여러 애플리케이션의 변경을 별도 작업 공간인 branch에서 검토한 뒤 main에 합치는 Global Branching도 같은 맥락에서 봐야 합니다. 현재 공식 문서는 부분 병합 실패(partial merge failure)가 생기면 일부 리소스만 먼저 합쳐지고 나머지는 branch에 남을 수 있으며, 이 상태를 자동으로 되돌릴 수 없다고 설명합니다. 비활성·보관 상태(inactive·archived)의 branch 전용 데이터도 보존 기간(retention) 설정에 따라 삭제될 수 있습니다. 사람 검토도 하나의 신호가 아닙니다. 승인 정책은 검토 자격, 필요한 승인 수, 작성자의 자기 승인 허용 여부를 따로 설정하므로 리뷰어가 있다는 사실만으로 독립적인 사람 승인이 보장되지는 않습니다. 따라서 branch 검토와 merge가 있다는 사실을 “모든 변경이 한 번에 성공하거나 자동으로 되돌아간다”거나 “검토 증거가 장기 보존된다”는 보장으로 읽으면 안 됩니다. (Global Branching core concepts, Global Branch lifecycle, Global Branching approval policies)
예를 들어 BI 화면의 설비 A, 정비 앱의 Equipment-1024, Agent가 조회한 센서 기록이 모두 같은 현실 설비를 가리킨다면, 조직은 이 셋을 같은 업무 객체로 다뤄야 합니다. Foundry Ontology의 힘은 그래프를 예쁘게 그리는 데 있지 않습니다. 여러 데이터·애플리케이션·Agent가 같은 업무 객체와 같은 변경 규칙을 기준으로 움직이게 만드는 운영 정본에 있습니다.
그래서 제작자가 “AIP를 쓰면서 온톨로지가 강력하다고 느꼈다”고 말한 것도 자연스럽습니다. AIP에서 Agent가 단순히 문서를 검색하는 것을 넘어 업무 객체·관계·행동을 다룰 수 있는 배경에 Ontology가 있기 때문입니다.
여기까지만 보면 OpenCrab은 이 구조를 작게 옮긴 도구처럼 보입니다. 하지만 공개 코드를 열어 보면 예상과 다른 장면이 나옵니다. Object·Link·Action의 축소 복사본보다, 운영 온톨로지에서 풀어야 할 질문을 전혀 다른 부품으로 나눈 흔적이 더 선명합니다.
공개 코드는 다른 답을 보여줍니다: OpenCrab은 작은 Foundry가 아니었습니다
AIP에서 영감을 받았다는 사실과 Foundry의 구조를 그대로 복제했다는 주장은 분리해야 합니다. 공개 코드에서는 Object·Link·Action을 1:1로 옮기기보다, 운영 온톨로지에서 체감한 문제를 OpenCrab식 부품으로 다시 나눈 흔적이 더 뚜렷합니다.
코드를 따라가며 가장 먼저 마주치는 것은 검색의 한계입니다.
문서를 검색하는 것만으로는 부족합니다. OpenCrab은 원문 관찰인 Evidence와 모델이 해석한 Claim을 나누고, Concept·Outcome까지 연결합니다. OpenCrab의 온톨로지형 Evidence 데이터에서도 Claim에 evidence_refs, confidence, claim type 같은 정보를 붙여 근거와 해석을 구분하는 패턴을 확인할 수 있습니다.
그다음에는 검색 결과를 행동과 연결하는 문제가 나타납니다. OpenCrab은 Outcome과 Lever를 따로 두고, 무엇이 중요한 결과인지와 사람이 무엇을 조절할 수 있는지를 구분합니다.
마지막으로 Agent가 움직이기 시작하면 권한 경계가 필요합니다. Subject, Resource, Policy와 ReBAC·Approval 같은 구성요소는 누가 무엇을 보고 바꾸고 승인할 수 있는지를 표현하려는 장치입니다.
OpenCrab 공개 저장소는 이 구조를 LocalCrab 온톨로지 공장과 호스팅 생태계를 잇는 형태로 설명합니다. 로컬 엔진은 문서·크롤링 자료·OCR 결과를 모으고, Evidence를 색인하고, 그래프를 검증해 OpenCrab Pack을 만드는 역할을 맡습니다. (OpenCrab README)
문서와 로그
→ Evidence 수집
→ 9-Space 그래프
→ 품질 검사와 승격
→ OpenCrab Pack
→ MCP로 Agent에 제공
Foundry가 운영 객체와 변경을 하나의 플랫폼에서 일관되게 관리하는 데 강하다면, OpenCrab은 비정형 자료를 근거가 있는 지식으로 가공해 Pack으로 옮기고 Agent에 연결하는 쪽에 더 무게가 실려 있습니다.
비교할 때 지켜야 할 경계
Foundry는 전사 운영 플랫폼이고 OpenCrab은 공개 코드 기준으로 알파 단계의 로컬 온톨로지 공장입니다. OpenCrab을 Foundry의 대체품으로 보기보다, AIP에서 경험한 운영 온톨로지의 문제를 로컬 Agent 환경에서 어떤 최소 부품으로 다시 풀었는지 보는 편이 정확합니다.
같은 설비 앞에서 두 시스템은 서로 다른 지도를 펼칩니다
도입의 설비 문제를 두 시스템에 차례로 넣어 보겠습니다. 베어링 진동이 계속 커지는 상황에서 현장팀은 점검 주기를 30일에서 14일로 줄이려 합니다. 변경하려면 정비 책임자의 승인이 필요하고, 변경 뒤에는 고장률과 비가동 시간을 추적해야 합니다.
Foundry에서는 운영 객체와 변경 계약을 먼저 세웁니다
Foundry식 모델은 다음에 가깝습니다.
Object
- Equipment
- InspectionPlan
- VibrationReading
- WorkOrder
- FailureEvent

Link
- Equipment has InspectionPlan
- VibrationReading observedOn Equipment
- WorkOrder targets Equipment

Action
- ChangeInspectionInterval
- CreateEmergencyWorkOrder

Function
- CalculateFailureRisk

Security
- MaintenanceManager만 점검 주기를 변경ChangeInspectionInterval은 단순한 버튼 이름이 아닙니다. Action type은 어떤 객체·속성·링크를 한 번에 바꿀지, 어떤 입력을 받을지, 누가 실행할 수 있는지, 제출 조건과 부수 효과가 무엇인지 정의합니다. 제출되면 변경이 Ontology에 반영되고 여러 애플리케이션에서 같은 규칙을 재사용할 수 있습니다. (Palantir Action types, Getting started with actions)
OpenCrab에서는 자료를 판단 가능한 의미 역할로 나눕니다
OpenCrab의 9-Space로 같은 장면을 읽으면 다음처럼 바뀝니다.
| Space | 설비 사례에서 찾는 것 | 예시 |
|---|---|---|
| Subject | 행동·소유·승인 주체 | 현장팀, 정비 책임자, Agent |
| Resource | 읽거나 수정하거나 실행할 대상 | 설비 매뉴얼, 점검표, 센서 데이터, API |
| Evidence | 직접 관찰하거나 인용한 근거 | 진동 측정값, 고장 로그, 보고서 문장 |
| Concept | 설명할 개체·상태·메커니즘 | 베어링 마모, 진동 증가 |
| Claim | Evidence에서 도출한 주장 | “진동 증가가 고장 위험을 높인다” |
| Community | 함께 묶이는 사건·개념군 | 반복 고장 패턴 묶음 |
| Outcome | 관리하려는 결과와 위험 | 비가동 시간, 고장 위험, 정비 비용 |
| Lever | 사람이 조절할 수 있는 값 | 점검 주기, 교체 임계값 |
| Policy | 권한·금지·승인 조건 | 주기 변경은 책임자 승인 필요 |
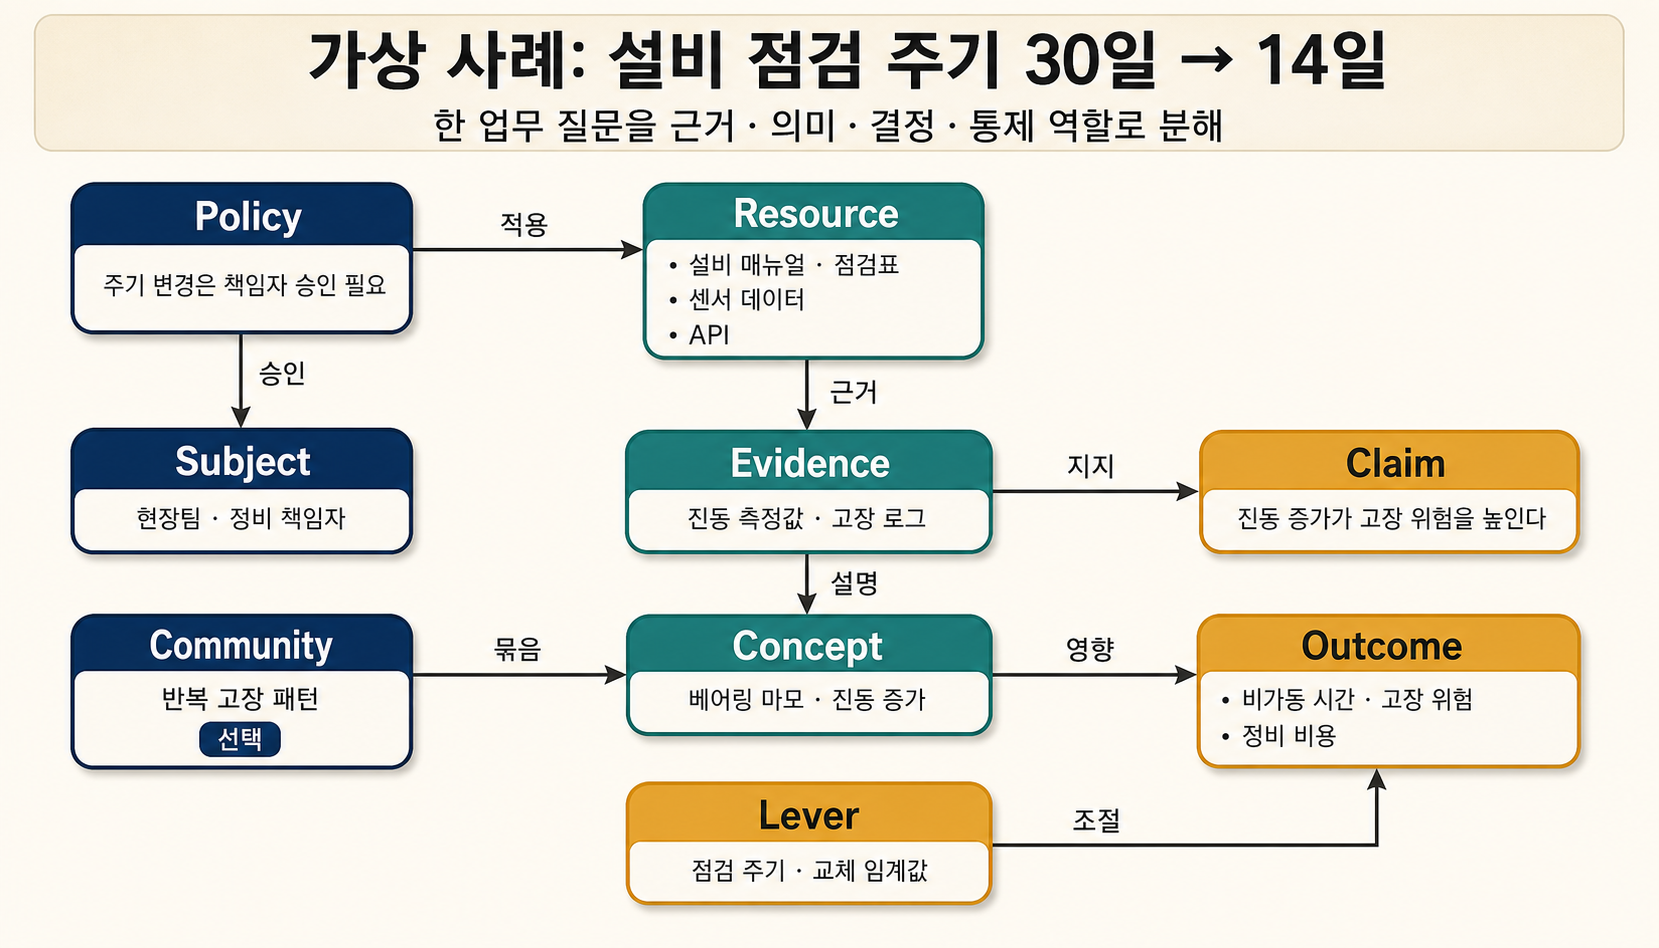
이 구조가 주는 변화는 단순합니다. 베어링, 진동, 점검이라는 단어를 찾는 데서 멈추지 않고, “이 판단은 어디서 나왔지?”를 다시 따라갈 수 있게 합니다. Evidence → Claim을 따로 둔 이유도 여기에 있습니다. 검색된 문장과 모델이 붙인 해석을 같은 사실로 섞지 않고, 어떤 근거가 어떤 주장을 지지하거나 반박하는지 남겨 두려는 것입니다.
- 어떤 Evidence가 고장 위험 Claim을 지지합니까?
- 위험과 비가동 시간에 영향을 주는 Lever는 무엇입니까?
- 누가 점검 주기를 바꿀 수 있습니까?
- 어떤 Policy가 승인을 요구합니까?
이 지점에서 OpenCrab은 일반적인 GraphRAG보다 의사결정에 가까워집니다. 다만 그래프가 실제 설비 관리 시스템의 값을 자동으로 바꾸는 것은 아닙니다. 의미를 읽고 판단 재료를 준비하는 일과 실제 운영 변경은 구분해야 합니다.
이제 두 번째 질문이 생깁니다. OpenCrab은 이렇게 나눈 의미를 어떤 규칙으로 연결할까요? 답은 9-Space의 닫힌 그래프 문법에 있습니다.
OpenCrab은 세계를 아홉 역할로 잘라 읽습니다
9-Space는 세 묶음으로 보면 기억하기 쉽습니다.
행동의 세계
Subject · Resource

지식의 세계
Evidence · Concept · Claim · Community

결정과 통제의 세계
Outcome · Lever · Policy
전통적인 상위 온톨로지는 객체·사건·시간·공간처럼 세계의 일반 존재 범주를 정의하는 경우가 많습니다. OpenCrab은 여기에 지식의 상태와 운영 역할을 함께 넣었습니다. 그래서 “경량 어퍼 온톨로지”라고 부를 수는 있지만, Agent가 자료를 읽고 판단하고 행동할 때 필요한 역할 문법이라고 설명하는 편이 더 정확합니다.
모든 Space가 서로 연결되는 것은 아닙니다
현재 공개 문법은 9개 Space 사이의 모든 조합을 허용하지 않습니다. 가능한 81개 방향 조합 중 11개만 열어 두고, 그 안에서 38개의 관계 이름을 사용합니다. (manifest.py)
| From → To | 허용 관계의 예 |
|---|---|
| Subject → Resource | owns, manages, can_view, can_edit, can_execute, can_approve |
| Resource → Evidence | contains, derived_from, logged_as |
| Evidence → Concept | mentions, describes, exemplifies |
| Evidence → Claim | supports, contradicts, timestamps |
| Concept → Concept | related_to, subclass_of, part_of, influences, depends_on |
| Concept → Outcome | contributes_to, constrains, predicts, degrades |
| Lever → Outcome | raises, lowers, stabilizes, optimizes |
| Lever → Concept | affects |
| Community → Concept | clusters, summarizes |
| Policy → Resource | protects, classifies, restricts |
| Policy → Subject | permits, denies, requires_approval |
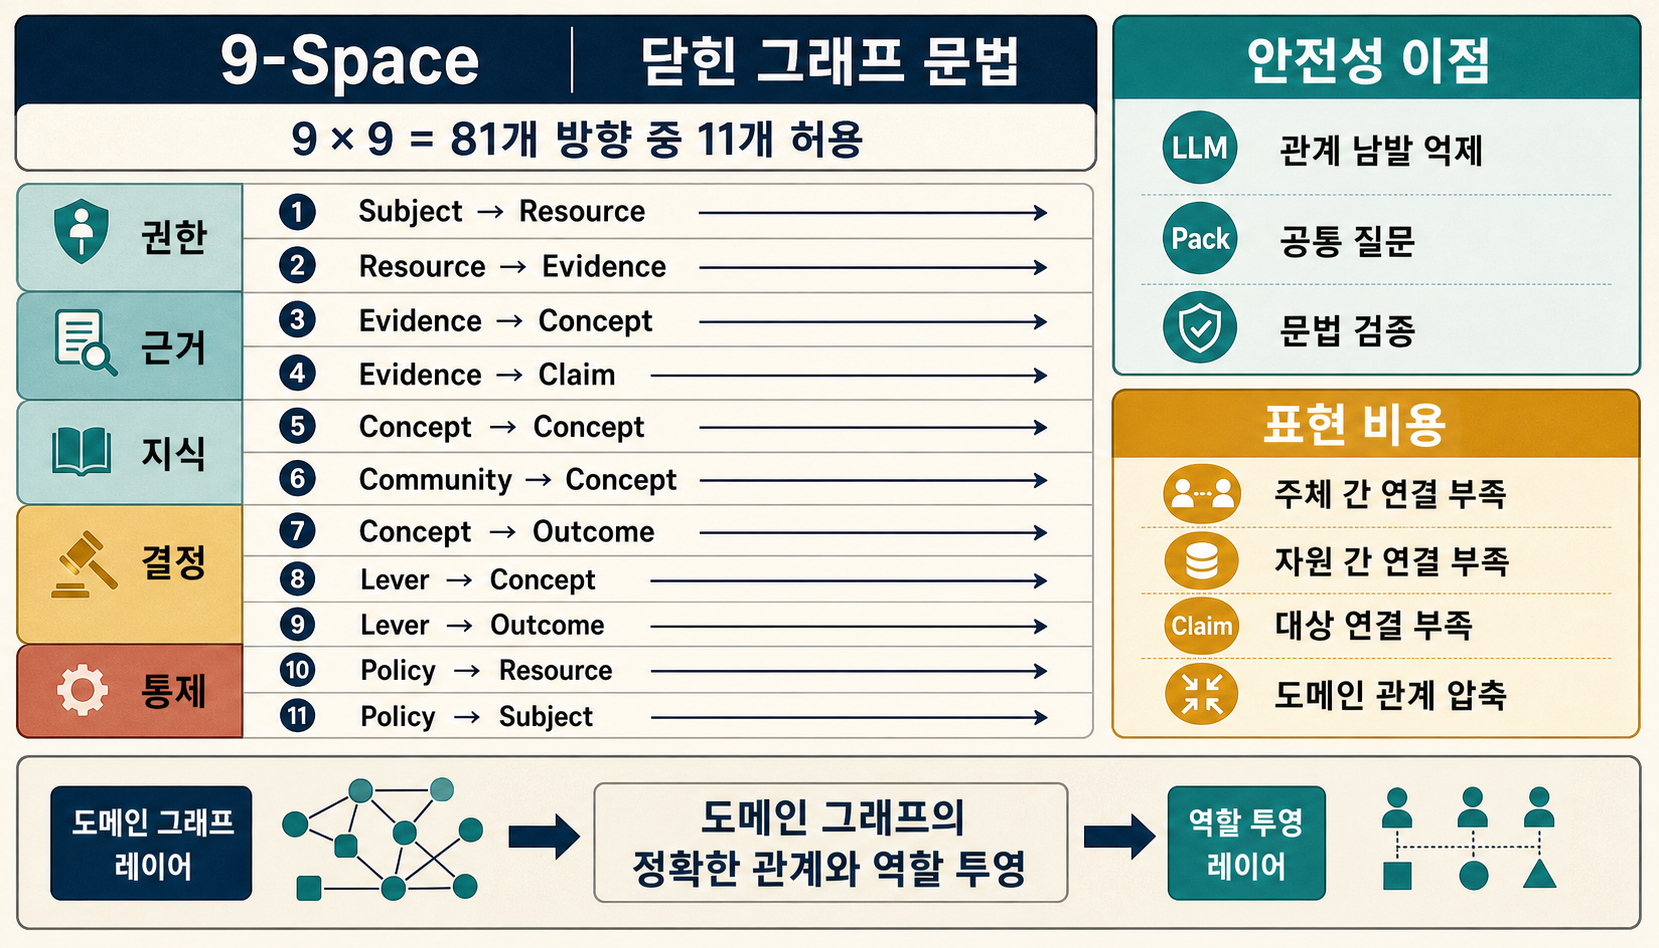
닫힌 문법은 LLM이 임의의 관계를 남발하지 못하게 합니다. Subject → mentions → Resource처럼 의미가 맞지 않는 연결은 저장 전에 거절할 수 있습니다. 서로 다른 Pack도 같은 기본 문법을 사용하므로 Agent가 공통된 질문을 던지기 쉬워집니다.
그 대가도 있습니다.
User → member_of → Team같은 Subject 간 조직 관계를 직접 표현하기 어렵습니다.Project → contains → Document같은 Resource 간 구조가 막힙니다.- Claim이 어떤 Concept나 Outcome에 관한 주장인지 직접 잇는 관계가 부족합니다.
- 의료의
CONTRAINDICATED_WITH, 건설의PROHIBITED_BY처럼 도메인 고유 관계가related_to나restricts로 압축될 수 있습니다.
그래서 9-Space를 현업 용어의 대체재로 쓰면 오히려 정보가 줄어듭니다. 설비·의료·법률마다 필요한 정확한 타입과 관계는 따로 남겨 두고, 9-Space는 그 위에서 Agent가 공통 질문을 던지도록 돕는 메타 스키마, 또는 역할 문법으로 쓰는 편이 자연스럽습니다.
도메인 그래프
Bearing -[REQUIRES_INSPECTION]-> InspectionProcedure

9-Space 역할 투영
Concept · Resource · Policy · Outcome
도메인 그래프는 현업의 정확한 의미를 보존하고, 9-Space는 질문 계획·근거 검사·Pack 호환을 위한 공통 렌즈로 쓰는 방식입니다.
여기서 가장 그럴듯한 오해가 하나 남습니다. 결과를 바꾸는 Lever가 있다면 Foundry의 Action도 대신할 수 있지 않을까요? 이 질문에서 두 시스템의 책임 차이가 다시 드러납니다.
결정적인 함정: Lever를 Action으로 읽으면 틀립니다
사용자 입장에서 가장 헷갈리기 쉬운 부분입니다.
Lever
= 무엇을 바꿀 수 있는가

Action
= 누가 어떤 조건과 입력으로 실제 변경을 실행하는가
설비 사례에서 점검 주기는 Lever입니다. 30일을 14일로 조절할 수 있는 값이기 때문입니다. 하지만 이것만으로 실제 시스템이 바뀌지는 않습니다.
Foundry의 Action에 가까운 OpenCrab 구성은 하나가 아니라 묶음입니다.
Lever
+ Action Schema
+ Workflow
+ Approval
+ ReBAC
+ Impact
+ Receipt와 Action Log
OpenCrab 공개 코드에는 YAML Action schema, workflow 상태, 승인 큐, 관계 기반 접근 제어와 실행 영수증이 있습니다. MCP 도구에도 workflow_create_run, workflow_advance, approval_request, ontology_rebac_check, ontology_impact가 노출됩니다. (tools.py)
구조만 보면 Foundry의 실행 계층에서 영감을 받은 해석이 가능합니다. 그러나 공개 구현에서는 이 부품들이 하나의 강제 경로로 묶여 있지 않습니다.
- Action schema가 없어도 실행을 허용하는 경로가 있습니다.
- Workflow는 허용된 상태 이름을 검사하지만 엄격한 전이표를 강제하지 않습니다.
- Approval 요청이 존재해도 모든 쓰기 도구가 승인 완료 여부를 확인하지는 않습니다.
- Lever simulation은 그래프 관계와 입력 크기를 조합한 휴리스틱이며 인과 추정 모델이 아닙니다.
그래서 OpenCrab의 실행 구조는 운영 Action의 골격으로 보는 편이 맞습니다. Foundry처럼 변경의 유일한 트랜잭션 경계가 되었다고 보기는 이릅니다.
실행 경계가 아직 하나로 닫히지 않았다면 OpenCrab의 강점은 어디에 있을까요? 답은 지식을 만드는 과정과 결과를 함께 옮기는 Pack에서 찾을 수 있습니다.
지식을 옮기는 상자, Pack 안에는 무엇이 들어갈까요
OpenCrab에서 Pack은 문맥에 따라 다른 뜻으로 사용됩니다.
| 이름 | 역할 |
|---|---|
| Schema Pack | 특정 도메인의 Node type schema를 설치하는 어휘 확장 |
| PromotionPackage | 한 Mission이 수집·검증한 Node와 Edge 후보 묶음 |
| OpenCrab Pack v1 | Graph·Evidence·품질 보고서·Neo4j 검증 결과를 담은 배포 ZIP |
이 가운데 OpenCrab의 제품 철학을 가장 잘 보여 주는 것은 Pack v1입니다. 공개 명세는 다음 파일을 하나의 배포 계약으로 묶습니다. (OpenCrab Pack v1)
manifest.json
graph/nodes.jsonl
graph/edges.jsonl
evidence/index.jsonl
quality/report.json
neo4j/import.cypher
neo4j/opencrab_ingest.jsonl
sample_queries.json
community_reports.json
이 ZIP은 그래프 백업이 아닙니다. “어떤 자료로 만들었고, 어느 문법 버전을 사용했고, 어떤 품질 검사를 통과했는가”를 함께 전달하는 지식 제품입니다.
Pack 간 연계는 ‘배포’와 ‘의미 결합’을 나눠 봐야 합니다
여러 Pack을 같은 생태계에 설치하고 Agent가 함께 검색하게 만드는 배포 연계는 OpenCrab이 분명히 염두에 둔 방향입니다. 공통 9-Space와 Pack 형식, MCP가 있기 때문에 법규 Pack과 설비 Pack을 같은 Agent가 읽는 그림을 만들 수 있습니다.
하지만 공개 Pack v1 명세에는 아직 다음과 같은 의미 결합 계약이 없습니다.
dependencies
imports · exports
namespace
required_packs
cross_pack_links
conflict_resolution
canonical_entity_mapping
따라서 현재 Pack은 조합 가능한 지식 묶음이지만, 패키지 관리자의 의존성 그래프처럼 서로의 버전과 충돌을 해결하는 모듈 시스템은 아닙니다.
가령 두 Pack이 같은 설비를 서로 다른 ID로 저장하거나, 점검 주기에 대해 상반된 Claim을 제공한다면 다음을 별도로 해결해야 합니다.
- 어떤 ID가 같은 현실 객체를 가리키는가?
- 어느 Pack과 revision을 우선할 것인가?
- 두 Claim의 Evidence는 서로 독립적인가?
- 더 강한 Policy가 다른 Pack의 Action을 제한하는가?
OpenCrab에는 alias와 duplicate candidate를 관리하는 Identity 계층이 있지만, 검색과 Pack federation 전체에 자동 적용되는 수준은 아닙니다. Pack 유통 구조는 보이지만 Pack 연합 의미론은 아직 비어 있다고 정리할 수 있습니다.
Pack이 검증한 지식을 담아 옮기는 상자라면, Agent는 그 안의 지식을 어떻게 꺼내 쓸까요? 여기서 OpenCrab의 가장 실용적인 선택인 MCP가 등장합니다.
Agent가 Pack을 여는 열쇠는 MCP입니다
MCP는 Agent가 저장소 내부 구조를 몰라도 의미 있는 도구를 호출하게 합니다. OpenCrab의 로컬 stdio 서버는 initialize, tools/list, tools/call을 처리하고, 도구 이름·입력 schema·실제 함수를 하나의 registry에 모읍니다. (server.py)
Agent 입장에서는 다음 차이가 큽니다.
저장소 직접 접근
Neo4j · Chroma · SQLite · JSON API를 각각 학습

MCP 접근
ontology_query · ontology_add_node · ontology_impact처럼
의미가 붙은 작업만 호출
먼저 알아야 할 핵심 도구 10개
| 도구 | 하는 일 |
|---|---|
ontology_manifest | 현재 9-Space와 허용 관계를 조회 |
ontology_ingest | 원문을 Vector·Document 저장소에 넣음 |
ontology_extract | LLM으로 원문에서 Node·Edge 후보를 추출 |
ontology_add_node | 문법 검사를 거쳐 Node를 기록 |
ontology_add_edge | Space 방향과 Relation을 검사해 Edge를 기록 |
ontology_query | Vector·BM25·Graph를 결합해 검색 |
query_bm25 | 정확한 용어 중심의 키워드 검색 |
ontology_rebac_check | Subject의 Resource 권한을 검사 |
ontology_impact | Node 변경의 I1~I7 영향 범위를 탐색 |
ontology_lever_simulate | Lever와 연결된 Outcome 변화 방향을 탐색 |
전체 30개 도구는 다음 영역으로 나뉩니다.
온톨로지·검색 10
Workflow·Approval 3
Identity·Canonicalization 7
Promotion 4
Schema Pack 3
Billing 2
CrabHarness 연결 1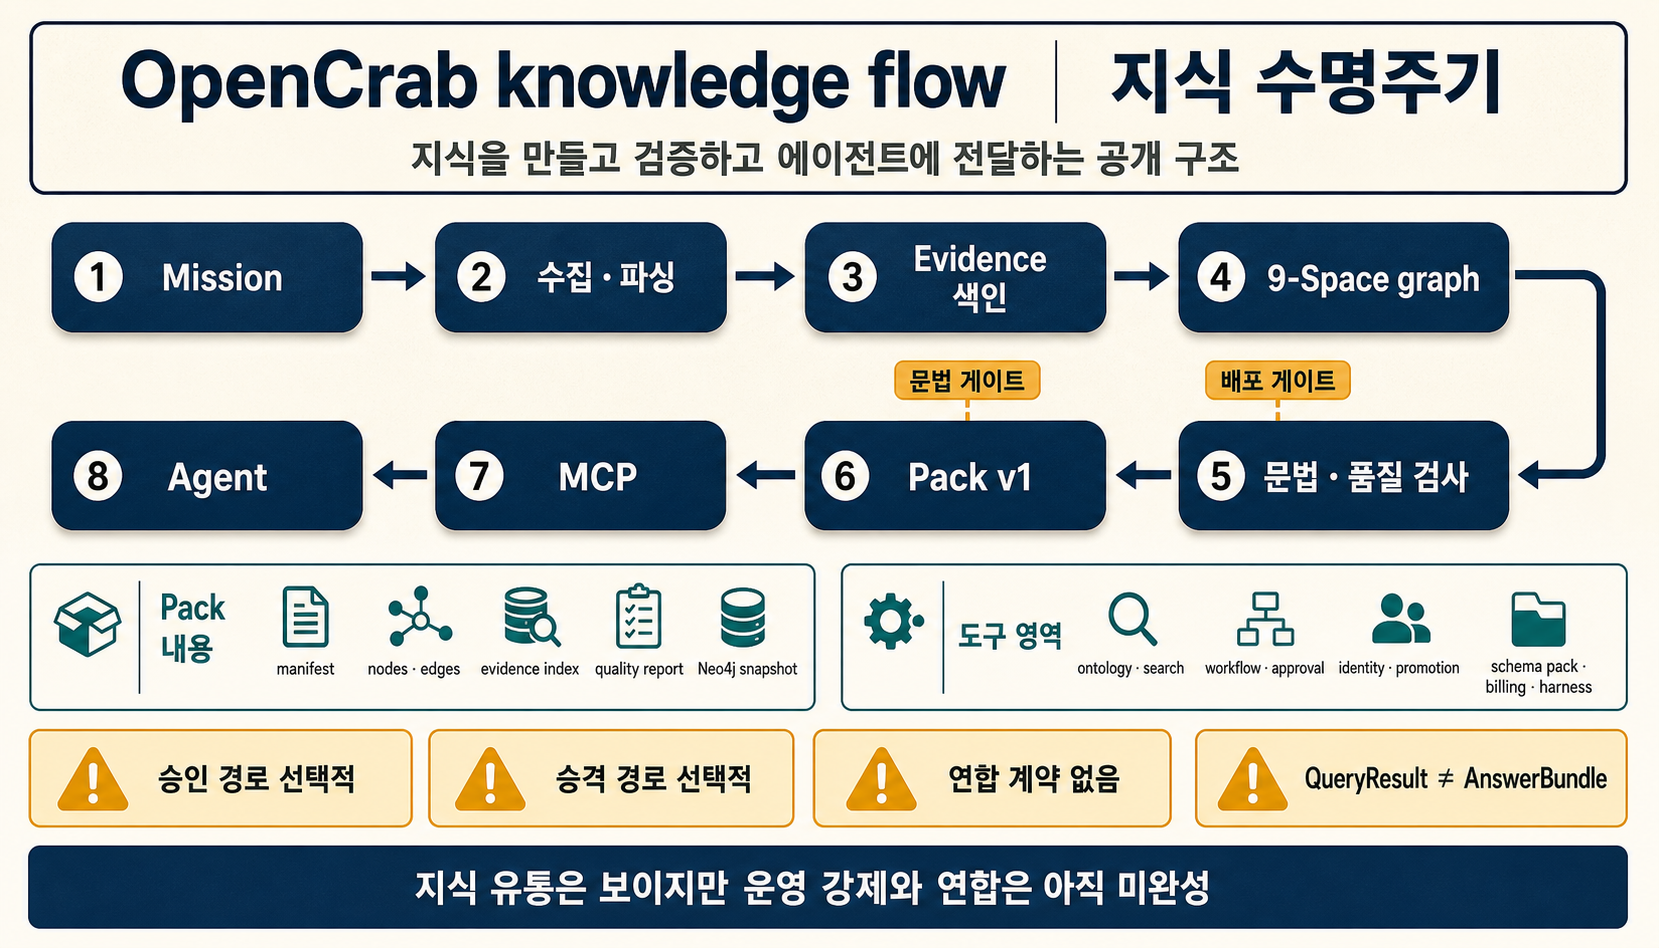
처음 접할 때는 30개를 외울 필요가 없습니다. 가장 작은 사용 흐름은 다음처럼 이해하면 됩니다.
자료 넣기
ontology_ingest
→ 그래프 후보 만들기
ontology_extract
→ 문법에 맞게 Node · Edge 기록
ontology_add_node · ontology_add_edge
→ Agent가 검색
ontology_query
→ 필요하면 권한 · 영향 확인
ontology_rebac_check · ontology_impact
MCP의 가치는 모델을 바꿔도 같은 도구 계약을 유지할 수 있다는 데 있습니다. Claude, Codex와 로컬 LLM이 같은 ontology_query를 호출할 수 있습니다. 저장 방식이 바뀌어도 Agent에게 노출되는 의미 도구를 유지할 수 있습니다.
다만 “MCP가 있다”와 “모든 변경이 하나의 안전한 명령 경계를 통과한다”는 다른 말입니다. CLI, REST API, stdio MCP와 다른 실행 표면이 동일한 내부 Command Service를 사용해야 문법·권한·승인·Evidence 검사를 한곳에서 강제할 수 있습니다. OpenCrab은 그 방향을 보여 주지만 공개 코드의 모든 경로가 완전히 합쳐진 상태는 아닙니다.
이제 처음의 베어링 문제로 돌아갈 수 있습니다. 문서를 찾고, 근거를 해석하고, 바꿀 값을 고르고, 실제 변경을 실행하는 책임을 어디까지 맡느냐에 따라 두 시스템의 정체가 갈립니다.
수수께끼의 답: 같은 문제를 맡지만 책임의 끝이 다릅니다
| 비교 축 | 팔란티어 Foundry | OpenCrab 공개 구조 |
|---|---|---|
| 시작점 | 조직의 운영 데이터와 실제 업무 객체 | 문서·로그·크롤링 자료와 Evidence |
| 의미 모델 | Object·Property·Link | 9-Space Node·Edge와 도메인 schema |
| 행동 | Action type·Function으로 운영 변경 | Lever·Action schema·Workflow·MCP 도구 |
| 권한 | Ontology resource와 데이터에 통합된 보안 | ReBAC·Policy·Approval의 경량 구성 |
| 검색·분석 | Object set, 애플리케이션, AIP 분석과 Agent | Vector·BM25·Graph 확장과 RRF |
| 배포 | Foundry DevOps와 Marketplace 제품 | Evidence와 품질을 담은 Pack ZIP |
| 강한 지점 | Action 계약·업무 규칙·전사 운영 통합 | 로컬성·이동성·근거 수집·Agent 연결 |
| 이 글에서 남는 경계 | 비용·ROI·실제 tenant 효과는 미검증 | 강제 게이트·Pack 연합·형식 보장이 미완성 |
팔란티어 공식 문서는 Ontology가 기업의 복잡하고 연결된 의사결정을 표현하며 사람과 AI Agent가 운영 흐름에서 협업하도록 설계됐다고 설명합니다. (The Ontology system) OpenCrab도 Outcome·Lever·Policy와 MCP를 통해 같은 방향을 바라봅니다.
차이는 “운영을 어디까지 책임지는가”에 있습니다. 기능 이름이 비슷해도 이 경계가 다르면 실제 사용 방식은 완전히 달라집니다.
Foundry
의미 모델 + 실행 계약 + 권한 + 실제 데이터 변경

OpenCrab
자료 수집 + 의미 그래프 + 검색 + Pack + Agent 도구
제작자가 밝힌 AIP 경험과 공개 구현을 함께 놓고 보면, OpenCrab이 가져온 문제의식을 한 문장으로 이렇게 읽을 수 있습니다.
온톨로지는 데이터 설명서가 아니라 Agent와 사람이 판단하고 행동할 때 공유하는 의미 계층이어야 한다.
이 문장은 제작자의 직접 인용이 아니라, 앞서 확인한 AIP 사용 경험과 OpenCrab 구조를 함께 읽어 정리한 해석입니다. OpenCrab은 그 문제를 전사 플랫폼이 아니라 로컬 공장·Pack·MCP라는 더 작은 부품으로 다시 나눴습니다.
매력은 선명하지만 빈칸도 함께 보입니다
잘 잡은 부분
Evidence와 Claim을 분리했습니다. 원문 관찰과 모델의 해석을 같은 사실로 취급하지 않는 출발점입니다.
Outcome과 Lever를 넣었습니다. 그래프를 “무엇과 관련 있는가”에서 “어떤 결과를 무엇으로 바꿀 수 있는가”까지 확장합니다.
Pack을 품질 계약으로 봅니다. Graph뿐 아니라 Evidence index, hash와 검증 결과를 함께 옮기려 합니다.
MCP를 도구 표면으로 선택했습니다. 모델과 저장소를 분리해 여러 Agent가 같은 의미 작업을 호출할 수 있습니다.
로컬 실행을 우선합니다. SQLite, JSON과 Chroma를 사용해 관리형 Graph 플랫폼 없이도 실험을 시작할 수 있습니다.
아직 남은 부분
9-Space가 질문 계획으로 완전히 작동하지 않습니다. 현재 검색은 관계형 단어를 감지해 후보 수와 Graph 깊이를 늘리지만, 질문마다 필수 Space와 경로를 선언하는 QueryPlan까지 만들지는 않습니다.
검색 결과가 AnswerBundle로 묶이지 않습니다. Claim·Evidence·Policy·Outcome·충돌·누락을 하나의 검증 단위로 반환하기보다 관련 Node 목록을 돌려줍니다.
Policy 표현과 권한 집행이 완전히 같은 계층은 아닙니다. 그래프에 적힌 Policy 관계가 모든 ReBAC 결정과 쓰기 작업을 자동으로 지배하지는 않습니다.
Promotion과 Approval은 선택적 프로토콜에 가깝습니다. 후보·검증·승격 상태가 있지만 모든 운영 쓰기가 그 순서를 반드시 거치지는 않습니다.
Pack 연합 계약이 없습니다. 여러 Pack의 ID·revision·Claim 충돌과 의존성을 다루는 공개 규격이 더 필요합니다.
형식 Reasoner가 아닙니다. HybridQuery와 Impact·Lever 기능은 관련 경로와 영향 후보를 찾는 데 유용하지만 논리적 필연성이나 인과 효과를 증명하지 않습니다.
직접 확인하려면 같은 장면을 두 번 모델링해 보십시오
OpenCrab을 소개할 때 전체 기능을 한 번에 외우기보다, 하나의 업무 장면을 두 방식으로 모델링해 보는 편이 좋습니다.
설비 점검 주기 사례로 다음 순서만 따라가도 차이가 드러납니다.
- Foundry식으로
Object·Link·Action·Function·Security를 적습니다. - 같은 자료를 OpenCrab의
Evidence·Claim·Outcome·Lever·Policy로 나눕니다. - 실제 현업 관계와 9-Space 공통 관계가 어디서 겹치고 어디서 손실되는지 표시합니다.
- Lever를 바꿀 때 필요한 Action schema, 승인, 권한과 영수증을 적습니다.
- 결과를 Pack으로 옮길 때 필요한 Evidence와 품질 검사를 확인합니다.
- 여러 Pack을 함께 쓸 때 ID와 Claim 충돌을 어떻게 처리할지 질문합니다.
두 모델을 나란히 놓으면 처음의 수수께끼가 실무 질문으로 바뀝니다. 어떤 보장을 플랫폼이 맡고, 어떤 판단을 Agent와 운영자가 맡는지를 직접 표시할 수 있기 때문입니다.
어디에 쓰면 맞고, 어디에서는 멈춰야 할까요
OpenCrab은 다음 조건에서 매력적입니다.
- 팔란티어 없이 운영 온톨로지의 사고방식을 작게 실험하고 싶을 때
- 사내 문서와 로그를 Evidence 중심 GraphRAG로 만들고 싶을 때
- 지식을 LLM 모델과 분리해 Pack으로 버전 관리하고 싶을 때
- Claude·Codex·로컬 LLM에 같은 MCP 도구를 제공하고 싶을 때
- 완벽한 형식 모델을 만들기 전에 질문과 근거 중심으로 시작하고 싶을 때
반대로 다음 요구가 강하면 OpenCrab만으로는 부족합니다.
- 변경이 반드시 하나의 트랜잭션과 권한 경계를 통과해야 할 때
- 법률·의료 판정에 형식 일관성과 결정론적 규칙이 필요할 때
- 여러 Pack의 의존성·충돌·전역 ID를 자동으로 관리해야 할 때
- Lever 변경의 인과 효과를 수치로 검증해야 할 때
- 모든 답변 Claim이 정확한 원문 구간과 자동으로 결합돼야 할 때
작은 실험의 기준도 여기서 나옵니다. 먼저 문서 검색이 어려운 업무 하나를 고르고, Evidence → Claim → Outcome → Lever → Policy 경로가 실제 판단을 더 잘 설명하는지 확인하면 됩니다. 그다음에만 Pack과 MCP를 붙여도 늦지 않습니다.
최종 판단: 같은 온톨로지라는 말 뒤에는 다른 책임이 있습니다
처음의 베어링 문제로 돌아가 보겠습니다. 진동 기록을 찾아 “점검 주기를 14일로 줄이자”는 문장을 만드는 것까지는 검색 시스템도 할 수 있습니다. 운영 온톨로지로 이어지려면 그 문장이 어떤 Evidence에서 나왔는지, 어떤 Outcome을 지키기 위한 Claim인지, 누가 Lever를 바꿀 수 있는지, 어떤 Policy가 승인을 요구하는지까지 설명해야 합니다. 그리고 실제 시스템의 주기를 바꾸려면 이 판단을 실행 계약과 권한, 승인, 결과 관측에 연결해야 합니다.
여기서 “OpenCrab은 작은 Foundry일 것”이라는 첫 답이 깨집니다. Foundry와 AIP는 Object·Link·Action·Function·Security, Logic·Evals·observability 같은 기능과 계약을 한 환경에서 연결할 수 있습니다. 다만 실제 승인·평가·변경 통합·실패 복구·증거 보존·사후 대응이 안전한 운영 루프로 이어지는지는 각 기능의 설정과 조직의 정책에 달려 있습니다. OpenCrab은 그 전체 운영 플랫폼을 재현하는 대신, 문서와 로그를 판단 가능한 지식으로 만드는 구간을 더 작은 부품으로 분해했습니다.
OpenCrab의 경로는 문서·로그 → Evidence → Claim·Concept·Outcome·Lever·Policy → 검사 → Pack → MCP → Agent입니다. 9-Space는 현업의 정밀한 도메인 그래프를 대신하지 않고 자료를 읽는 공통 역할 문법으로 작동합니다. Pack은 그래프와 함께 Evidence와 품질 정보를 옮기는 배포 단위이며, MCP는 여러 모델이 같은 의미 작업을 호출하게 하는 도구 계약입니다. 원문 관찰과 모델 해석을 분리하고 근거 경로를 모델 밖에 남긴다는 점이 OpenCrab을 단순 문서 검색보다 의사결정에 가까운 지식 구조로 만듭니다.
하지만 이 판단은 공개 OpenCrab 커밋 d34352cec9d99c755c1e891f811911461a460280과 본문에 인용한 공개 문서를 기준으로 합니다. Action schema·Workflow·Approval·ReBAC 같은 부품은 있어도 모든 쓰기가 하나의 강제된 실행 경계를 통과하지는 않습니다. 여러 Pack의 ID·revision·Claim 충돌을 해결하는 연합 계약도 아직 확인되지 않았고, HybridQuery와 Lever simulation은 형식 Reasoner나 인과 효과 추정 모델이 아닙니다. 강한 트랜잭션·권한 집행·형식 판정·인과 검증이 필요한 업무라면 별도의 결정론적 계층이나 더 강한 운영 플랫폼이 필요합니다.
따라서 첫 실험은 작게 잡는 편이 낫습니다. 실제 업무 하나를 Foundry식 Object·Link·Action·Function·Security와 OpenCrab식 Evidence → Claim → Outcome → Lever → Policy로 각각 적어 보십시오. 후자의 구조만으로도 근거를 되짚고 승인 경계를 설명할 수 있다면 Pack과 MCP로 넓혀 갈 수 있습니다. 반대로 실제 변경을 강제하는 계약이 핵심이라면 그 책임을 OpenCrab에 넘기지 말아야 합니다. 같은 온톨로지라는 이름보다 중요한 것은, 판단이 근거에서 행동으로 넘어가는 동안 어느 경계를 누가 책임지는가입니다.
함께 읽기
- 8. OpenCrab 온톨로지 빌드는 무엇을 만드는가
- 9. LLM 시대, 온톨로지는 문맥 컴파일러로 이동하는가
- 10. 온톨로지 Expertise Pack 설계
- 11. 지식그래프가 LLM의 계획을 어떻게 돕는가
참고 자료
- Palantir, Ontology overview
- Palantir, Ontology core concepts
- Palantir, The Ontology system
- Palantir, Action types overview
- Palantir, Action types getting started
- Palantir, AIP overview
- Palantir, AIP Logic staged writes
- Palantir, AIP Logic integration with Automate
- Palantir, AIP Evals
- Palantir, Global Branching core concepts
- Palantir, Global Branch lifecycle
- Palantir, Global Branching resource protection and approval policies
- OpenCrab 제작자, Palantir AIP 사용 경험과 OpenCrab 개발 배경
- OpenCrab, 공개 통합 저장소
- OpenCrab, 9-Space grammar manifest
- OpenCrab, MCP tool registry
- OpenCrab, OpenCrab Pack v1